Du willst in Claude einen Kundenvertrag mit Namen und Adressen zusammenfassen lassen. Darfst du das?
Mit Team, Enterprise oder der direkten API grundsätzlich ja, denn dort gibt es einen AVV. Mit Free, Pro, Max oder Ultra nein, egal wie teuer das Abo ist.
Beim Claude Datenschutz entscheidet aber nicht nur der Tarif. Danach kommen die Schalter, denn Training, Memory, Projekte und Integrationen speichern Daten auf eigenen Wegen.
Hier siehst du für jeden Claude-Zugang, welcher Vertrag gilt, welcher Schalter zählt und was Anthropic wie lange behält. Für Claude Code bekommst du sieben Schritte, die du sofort umsetzen kannst.
- Für Kunden- oder Beschäftigtendaten brauchst du Team, Enterprise oder die direkte API, denn nur dort gilt Anthropics AVV.
- Bei Free, Pro, Max und Ultra entscheidet der Schalter „Help improve our AI models“ über das Training. Feedback und Sicherheitsfälle laufen getrennt.
- Chatverlauf, Memory, Projekte und Artifacts haben eigene Speicherregeln. Zero Data Retention (ZDR) braucht eine Freigabe und gilt nur für geeignete Funktionen.
1. Wann Claude DSGVO-konform ist und wann nicht
Claude ist DSGVO-konform nutzbar, wenn drei Bedingungen zusammenkommen.
- Vertrag: Für Kunden- oder Beschäftigtendaten nutzt du Team, Enterprise oder die direkte API. Dort gelten die Commercial Terms samt AVV.
- Schalter: Training, Memory, Projekte und Integrationen stellst du so ein, dass nur die nötigen Daten fließen.
- Eigene Pflichten: Rechtsgrundlage, Information der Betroffenen und Drittlandtransfer klärst du selbst. Das nimmt dir kein AVV ab.
Fehlt eine davon, ist dein Einsatz nicht abgesichert. Free, Pro, Max und Ultra scheitern schon an der ersten Bedingung, weil Anthropic dort keinen AVV anbietet.
Ich nutze selbst einen privaten Claude-Tarif. Für Kundendaten wäre das trotzdem der falsche Tarif, deshalb würde ich dort nur eigene Inhalte ohne fremde personenbezogene Daten eingeben.
Was in den einzelnen Zugängen konkret gilt, zeigt die Tabelle:

Training und Speicherdauer sind zwei getrennte Fragen, deshalb halte ich sie strikt auseinander.
Bei Kundendaten können außerdem Anthropic, AWS und Google für verschiedene Schritte zuständig sein. Welcher Vertrag für dich gilt, hängt an deinem Login. Doch welcher Zugang ist eigentlich deiner?
2. Tarif, Anmeldeweg und Ausführung bestimmen die Regeln
Hinter dem Namen Claude stecken mehrere Verträge. Ein AVV (Auftragsverarbeitungsvertrag) regelt, wie ein Anbieter personenbezogene Daten in deinem Auftrag verarbeitet. Auf Englisch heißt er bei Anthropic Data Processing Addendum (DPA).
Über die API, eine Programmierschnittstelle, bindest du Claude in eigene Software ein. Für diesen Zugang gelten eigene Vertrags- und Speicherregeln.
Free, Pro, Max und Ultra sind persönliche Claude-Tarife. Team und Enterprise fallen unter die Commercial Terms samt AVV. Bei Claude for Education verwaltet die Hochschule das Konto und ihren Vertrag. Ein Organisations-API-Schlüssel gehört zu einem eigenen Platform-Zugang.
Claude Code kann mehrere dieser Zugänge verwenden. Ich würde deshalb zuerst auf den tatsächlichen Login schauen, nicht auf den Namen der App.
Auch die Desktop-App führt leicht in die Irre, denn sie ist ein lokales Programm, verarbeitet aber nicht jede Aufgabe lokal.
Bei einer lokalen Cowork-Ausführung läuft der Agent zwar auf deinem Rechner. Für die Antwort sendet er die benötigten Eingaben trotzdem an Anthropic. Eine neue Cowork-Aufgabe auf einem Pro-, Max- oder Ultra-Konto läuft seit dem 6. Oktober 2026 standardmäßig in der Cloud.
Über AWS Bedrock oder Google Cloud ändern sich die Vertragswege noch einmal. Für Bedrock greifen AWS-Bedingungen und die einbezogenen Commercial Terms von Anthropic. Für Claude auf Google Cloud verweist die Google-Dokumentation auf die Regel „Separate Offerings“ im Abschnitt AI/ML Services. Diese Regel steht in den Service Specific Terms, dazu kommen separate Bedingungen in der passenden Modellkarte.
Der Vertrag ist allerdings nur die halbe Antwort, denn bei privaten Konten steckt die andere Hälfte in einem einzigen Schalter.
3. Wann Anthropic private Chats fürs Training nutzen kann
Bei Free, Pro, Max und Ultra trainiert Anthropic nur unter bestimmten Bedingungen mit deinen Chats. Die spezifische Trainingshilfe unterscheidet drei Fälle. Du erlaubst es per Schalter, du stimmst gesondert zu, oder eine Unterhaltung wird als Sicherheitsfall markiert. Das gilt auch für Claude-Code-Sitzungen.
Die aktuelle Privacy Policy formuliert den Trainingszweck allgemeiner. Einen einheitlichen Startzustand für jedes Konto gibt keines der Dokumente vor. Bei dir kann der Schalter also an oder aus stehen.
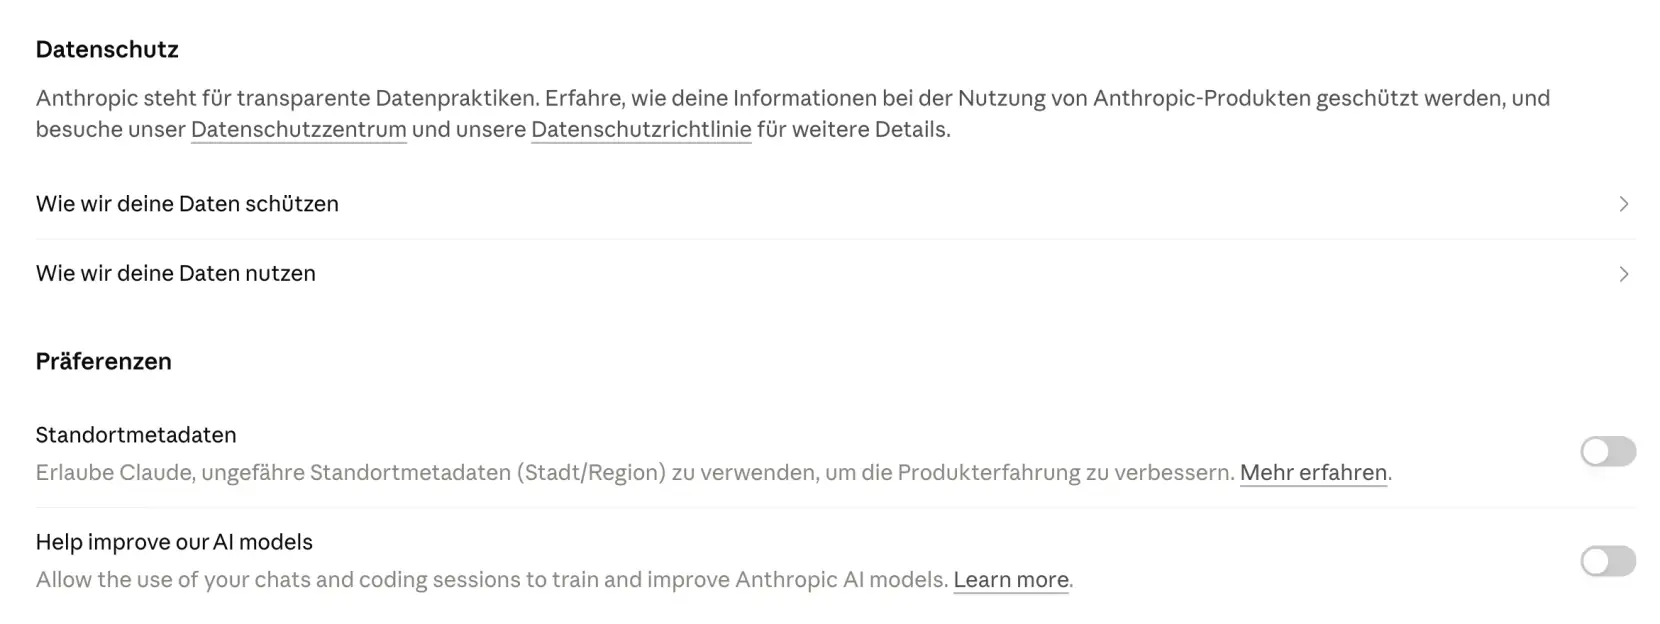
Du findest ihn unter Einstellungen > Datenschutz > Helfen Sie uns, unsere KI-Modelle zu verbessern. Er regelt die Modellverbesserung, nicht die Chatlöschung oder jede andere Speicherung. Eine Änderung wirkt für künftige Verwendungen. Daten aus einem begonnenen oder abgeschlossenen Trainingslauf holt sie nicht zurück.
Ich würde ihn ausschalten, bevor du den ersten vertraulichen Chat beginnst.
3.1 Feedback und Sicherheitsausnahmen
Auch mit ausgeschaltetem Schalter gibt es zwei Ausnahmen.
Die erste betrifft Sicherheitsfälle. Als Sicherheitsfall markierte Unterhaltungen darf Anthropic weiter für interne Sicherheitsmodelle, Richtlinienkontrolle oder Sicherheitsforschung verwenden. Das ist enger als gewöhnliches Training. „Aus“ heißt aber nicht, dass Anthropic nichts mehr verarbeitet.
Die zweite Ausnahme ist Feedback, denn bei einer Daumenbewertung kann Anthropic die gesamte zugehörige Unterhaltung bis zu fünf Jahre speichern. Es darf sie dann für Analyse oder Modellverbesserung verwenden. Bei anderen Feedback- oder Fehlerberichten gilt die Frist nur für die tatsächlich übermittelten Daten. Im privaten Trainingskontext können auch Inhalte aus Claude in Chrome dazukommen.
Rohdaten aus angebundenem Google Drive und aus lokalen oder entfernten MCP-Servern sind dagegen grundsätzlich ausgeschlossen, so die Trainingshilfe. Das gilt, solange du sie nicht direkt in den Chat kopierst. Im Modellkontext können sie trotzdem landen, und der verbundene Anbieter kann sie speichern.
Für Team, Enterprise und die direkte API ist die Lage einfacher. In seiner kommerziellen Trainingsrichtlinie sagt Anthropic zu, Customer Content standardmäßig nicht fürs Training zu verwenden. Eigene Regeln haben nur ausdrückliche Verbesserungsprogramme und eingereichtes Feedback.
Ob dein gesamter Ablauf zulässig ist, entscheiden aber weder AVV noch Opt-out. Und wie lange Anthropic deine Daten behält, regeln ganz eigene Fristen.
4. Warum 30 Tage und fünf Jahre verschiedene Dinge meinen
Jede dieser Fristen gehört zu einem bestimmten Datenweg. Für private Konten gelten diese Fristen:
- Normaler privater Chat: Für einen nicht gelöschten Chat nennt die öffentliche Hilfe keine pauschale 30-Tage-Frist. Er kann in deiner Historie bleiben, bis du ihn entfernst oder eine andere Kontoregel greift.
- Gelöschter privater Chat: Anthropic sagt, er verschwindet sofort aus der Historie und innerhalb von 30 Tagen aus dem Backend. Gesetzliche Pflichten und bestimmte Sicherheits- oder Missbrauchsfälle können davon abweichen.
- Modellverbesserung: Inhalte, die nach deiner Freigabe in die Trainingspipeline gehen, können dort bis zu fünf Jahre bleiben. Sie sind dann von deiner Nutzerkennung getrennt.
- Feedback: Eine Daumenbewertung kann die ganze zugehörige Unterhaltung bis zu fünf Jahre speichern lassen. Andere Feedback- und Fehlerberichte betreffen nur die eingereichten Daten. Ich würde vertrauliche Inhalte vor dem Absenden entfernen.
- Sicherheitsfall: Bei einem markierten Verstoß können Eingaben und Antworten bis zu zwei Jahre gespeichert werden. Klassifikationswerte bleiben bis zu sieben Jahre.
Bei Team und Enterprise bleiben gespeicherte Chats ebenfalls im Verlauf, bis du sie löschst oder eine Organisationsregel greift. Enterprise kann eigene Aufbewahrungsfristen einstellen.
Nach einer Chatlöschung ist die Backend-Löschung gewöhnlich innerhalb von 30 Tagen vorgesehen, mit Ausnahmen. Die kommerziellen Speicherregeln trennen das von gewöhnlichen direkten API-Ein- und Ausgaben, die Anthropic automatisch innerhalb von 30 Tagen löscht.
Compliance-Transkripte, API-Dateien, Batches, Feedback, Sicherheitsdaten und lokale Dateien haben eigene Regeln. Am deutlichsten merkst du das, wenn du einen Chat wirklich loswerden willst.
5. Was Inkognito, Chatlöschung und Kontolöschung bewirken
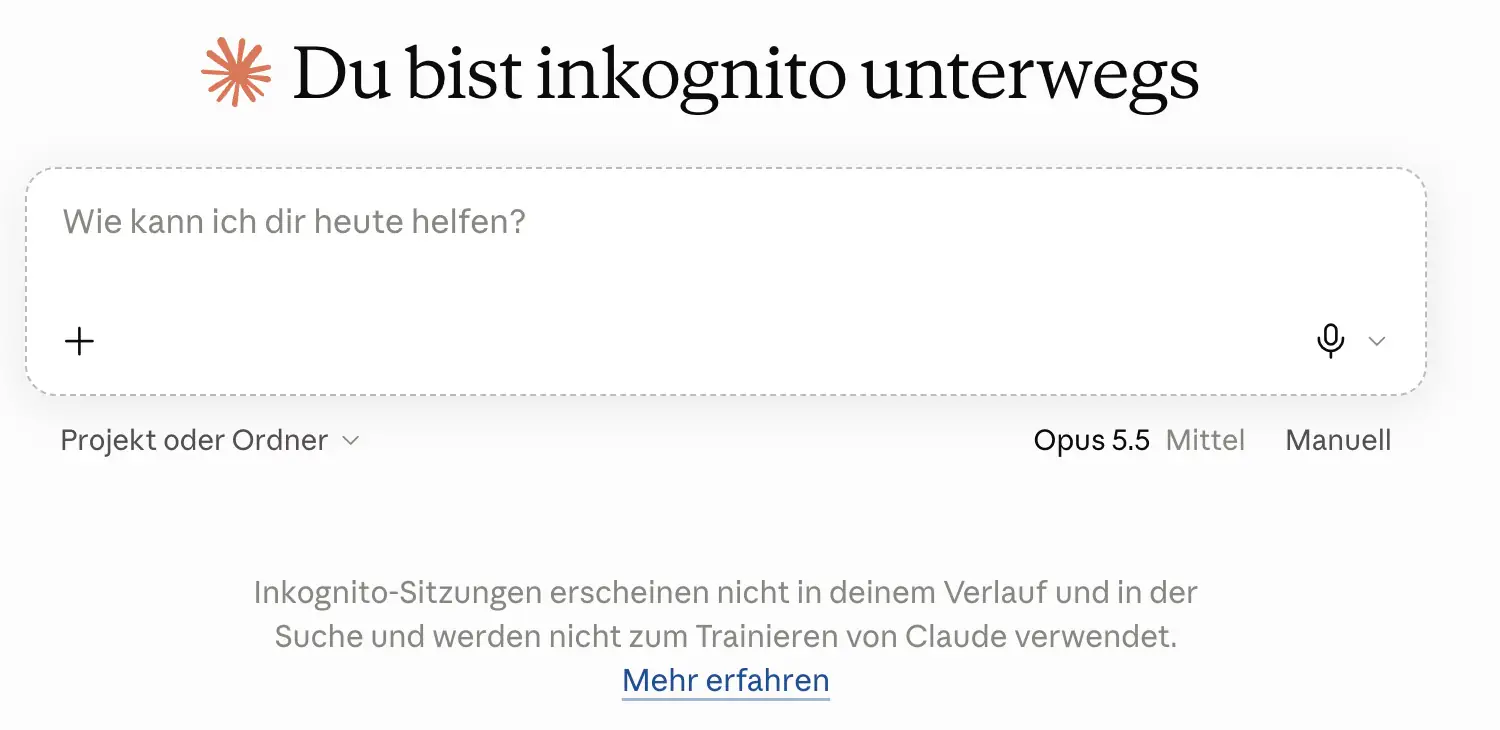
Auch ein Inkognito-Chat ist nicht einfach weg, obwohl er nach Anthropics Angaben weder im normalen Verlauf noch in Memory landet.
Er dient nicht der Modellverbesserung und taucht in der Suche nach früheren Unterhaltungen nicht auf. Trotzdem bewahrt Anthropic ihn standardmäßig 30 Tage auf. Für Team und Enterprise können Organisationsregeln oder Exporte hinzukommen.
Eine Stelle bleibt offen. Die Inkognito-Hilfe verspricht, dass diese Chats nicht ins Training gehen. Die allgemeine Sicherheitsrichtlinie erlaubt aber eine längere Nutzung markierter Unterhaltungen für interne Sicherheitsmodelle. Wie beides zusammenpasst, klären die öffentlichen Dokumente nicht eindeutig.
Ich sehe Inkognito deshalb weder als Nullspeicher noch als Zero Data Retention.
So sieht eine leere Inkognito-Unterhaltung in der Desktop-App aus. Der Hinweis unter dem Eingabefeld beschreibt Verlauf, Suche und Training:
Löschst du eine normale Unterhaltung, verschwindet sie sofort aus deiner Ansicht. Die Backend-Löschung soll innerhalb von 30 Tagen abgeschlossen sein.
Konto, Projektwissen, Artifact-Daten, übermittelte Feedback-Datensätze und Kopien bei verbundenen Diensten löscht dieser Schritt nicht automatisch. Bei Memory kommt es auf die Version an. Im neuen Erlebnis bleiben erzeugte Einträge bestehen, die ältere Zusammenfassung folgt den Regeln der Quellchats.
Für einzelne Chats heißt der deutsche Pfad Chats und Aufgaben > ⋮ > Löschen. Das ist etwas anderes als Archivieren oder der Inkognito-Modus.
Die Kontolöschung ist endgültig und nimmt dir den Zugang zu den Gesprächen. Einen einheitlichen Termin für die vollständige Löschung aller zugehörigen Datenarten nennt die Anleitung nicht, deshalb exportierst du wichtige Daten vorher. Bei einem Organisationskonto klärst du Vertrag und Zuständigkeit vorher mit dem Admin.
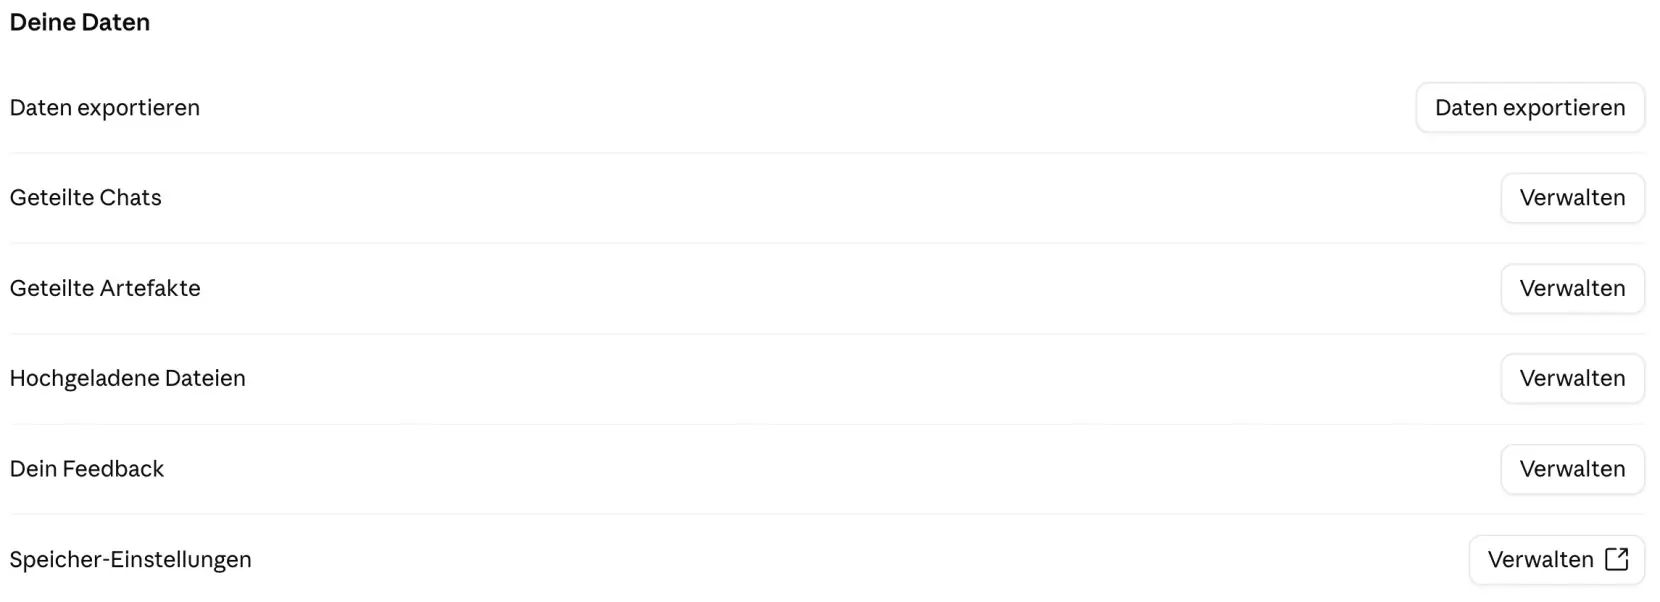
Unter Einstellungen > Datenschutz > Deine Daten findest du den Datenexport und getrennte Verwaltungsbereiche für Freigaben, Uploads, Feedback und Speicher:
Am hartnäckigsten ist dabei Memory, denn es lebt über einzelne Chats hinaus.
6. Was Memory über Chats hinweg behalten kann
Im neuen Memory-Erlebnis speichert Claude einzelne Themen, während du chattest. Jedes Projekt hat zusätzlich einen eigenen Speicherbereich und eine Projektzusammenfassung. Für Free, Pro, Max und Ultra ist diese Version im Web, in der Desktop-App und mobil standardmäßig eingeschaltet.
Bei Team und Enterprise entscheiden Owner, ob Mitglieder die neue Version nutzen dürfen. Jedes Mitglied schaltet sie dann für sich ein. Organisationen mit HIPAA oder Behördenstatus erhalten die neue Version nicht. Organisationen mit eigener Aufbewahrungsfrist bekommen sie nur mit der neuen einheitlichen Claude-Erfahrung.
Einige wenige Team- und Enterprise-Organisationen haben noch die ältere Version. Sie heißt in den Einstellungen „Capabilities“ statt „Memory“ und erstellt eine Zusammenfassung aus Chats. Laut Anthropic wird sie aktualisiert, wenn zugrunde liegende Gespräche gelöscht werden oder ablaufen.
6.1 Wie du Memory steuerst und löschst
In der neuen Version kannst du Themen ansehen, bearbeiten oder löschen. „Pausieren“ behält vorhandene Einträge. „Zurücksetzen“ löscht alle Einträge endgültig, auch die Projekt-Memory. Schaltet ein Owner Memory für die ganze Organisation aus, löscht Anthropic alle bestehenden Einträge sofort.
Für einen einzelnen Chat schaltest du Memory vor der ersten Nachricht aus.
Anders als ein Inkognito-Chat bleibt er im Verlauf.
Claude kann ihn über die Suche in früheren Chats trotzdem finden, wenn dein bezahltes Konto diese Funktion hat. Das betrifft alle bezahlten Tarife. Nach dem Rollout ist sie standardmäßig an und lässt sich in den Memory-Einstellungen ausschalten.
Löschst du im neuen Erlebnis einen Chat, bleiben daraus erzeugte Memory-Einträge bestehen. Die entfernst du einzeln.
Die alte Zusammenfassungs-Version bindet Anthropic dagegen an die Regeln der Quellchats. Beide Versionen können in Datenexporten auftauchen. Bestimmte sensible Themen speichert Memory standardmäßig nicht, für andere gelten zusätzliche Einschränkungen.
Cloud-Cowork kann im neuen Erlebnis dieselbe Memory wie der Chat verwenden, lokale Cowork-Sitzungen nutzen sie nicht. Die ältere Version gibt es für Cowork nicht. Ausgeschaltete Memory löscht übrigens weder Verlauf noch Projektwissen oder Cowork-Dateien.
In dieser Desktop-Ansicht liegen unter Einstellungen > Speicher zwei getrennte Schalter. „Chats durchsuchen und heranziehen“ ist eingeschaltet, „Gedächtnisgenerierung aus Chats“ ausgeschaltet. Bezeichnungen und Kontrollen hängen laut deutscher Memory-Hilfe von deiner Memory-Version ab:
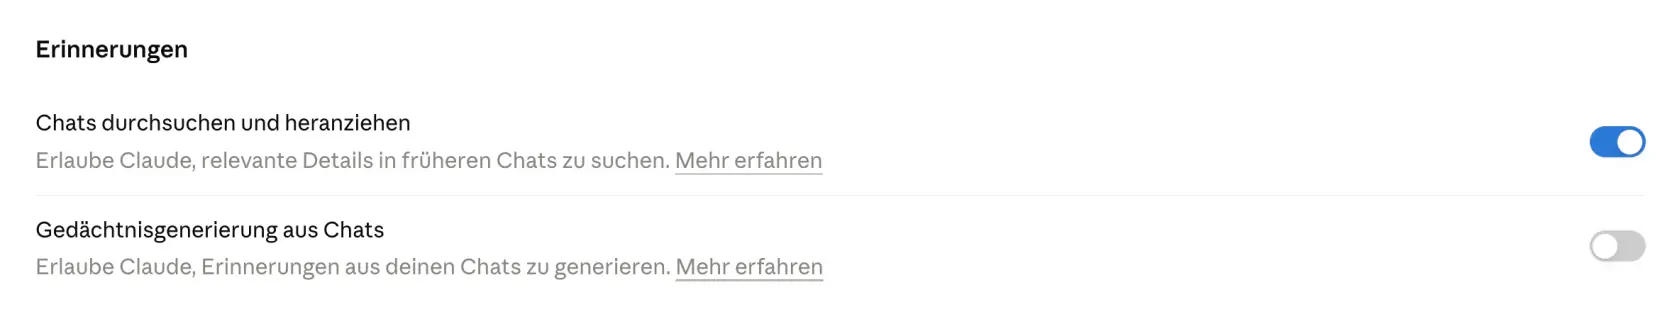
Für Kundenarbeit würde ich die Gedächtnisgenerierung ausgeschaltet lassen. Projekte legen nämlich noch einmal eigene Kopien an.
7. Projekte und Artifacts können eigene Kopien behalten
Projekte gibt es in allen Tarifen, bei Free bis zu fünf, so die Projects-Hilfe. Projektdateien und Wissen stehen allen Chats dieses Projekts als gemeinsamer Kontext zur Verfügung. Team und Enterprise können intern teilen, soweit die Organisationsregeln es erlauben.
Archivieren ist kein Löschen. Ein archiviertes Projekt behält Gespräche, Wissen und Freigaben. Zum Löschen stellst du es zuerst wieder her. Die Enterprise-Aufbewahrungsregeln geben der Projektregel Vorrang vor der Chatregel.
Ohne eingestellte Projektfrist kann Projektwissen unbegrenzt bestehen. Die 30 Tage für gelöschte Einzelchats gelten hier nicht.
Auch Artifacts sind keine einfachen Chatnachrichten. Alle Pläne können laut Artifact-Hilfe Artifacts erstellen.
Apps, Verbindungen und Datenspeicherung zwischen Sitzungen gibt es aber nur in bezahlten Tarifen, in Team und Enterprise steuern Admins sie. Je nach Artifact entstehen persönliche und geteilte Daten. Geteilte Inhalte können andere Nutzer sehen oder verwenden.
Bevor du etwas hochlädst oder freigibst, schau dir deshalb drei Dinge an. Was speichert das Artifact, wer greift darauf zu, und ist eine öffentliche Freigabe aktiv?
Ein geteilter Chat erzeugt einen Snapshot und folgt anderen Regeln als ein geteiltes Artifact. Löschst du den Chat oder entziehst den Link, verschwinden gespeicherte oder exportierte Kopien nicht garantiert.
Unter Einstellungen > Datenschutz > Geteilte Artefakte > Verwalten kontrollierst du veröffentlichte Artifacts. Die Code-Artifact-Liste ist hier mit „Datenschutz-Demo“ gefiltert:
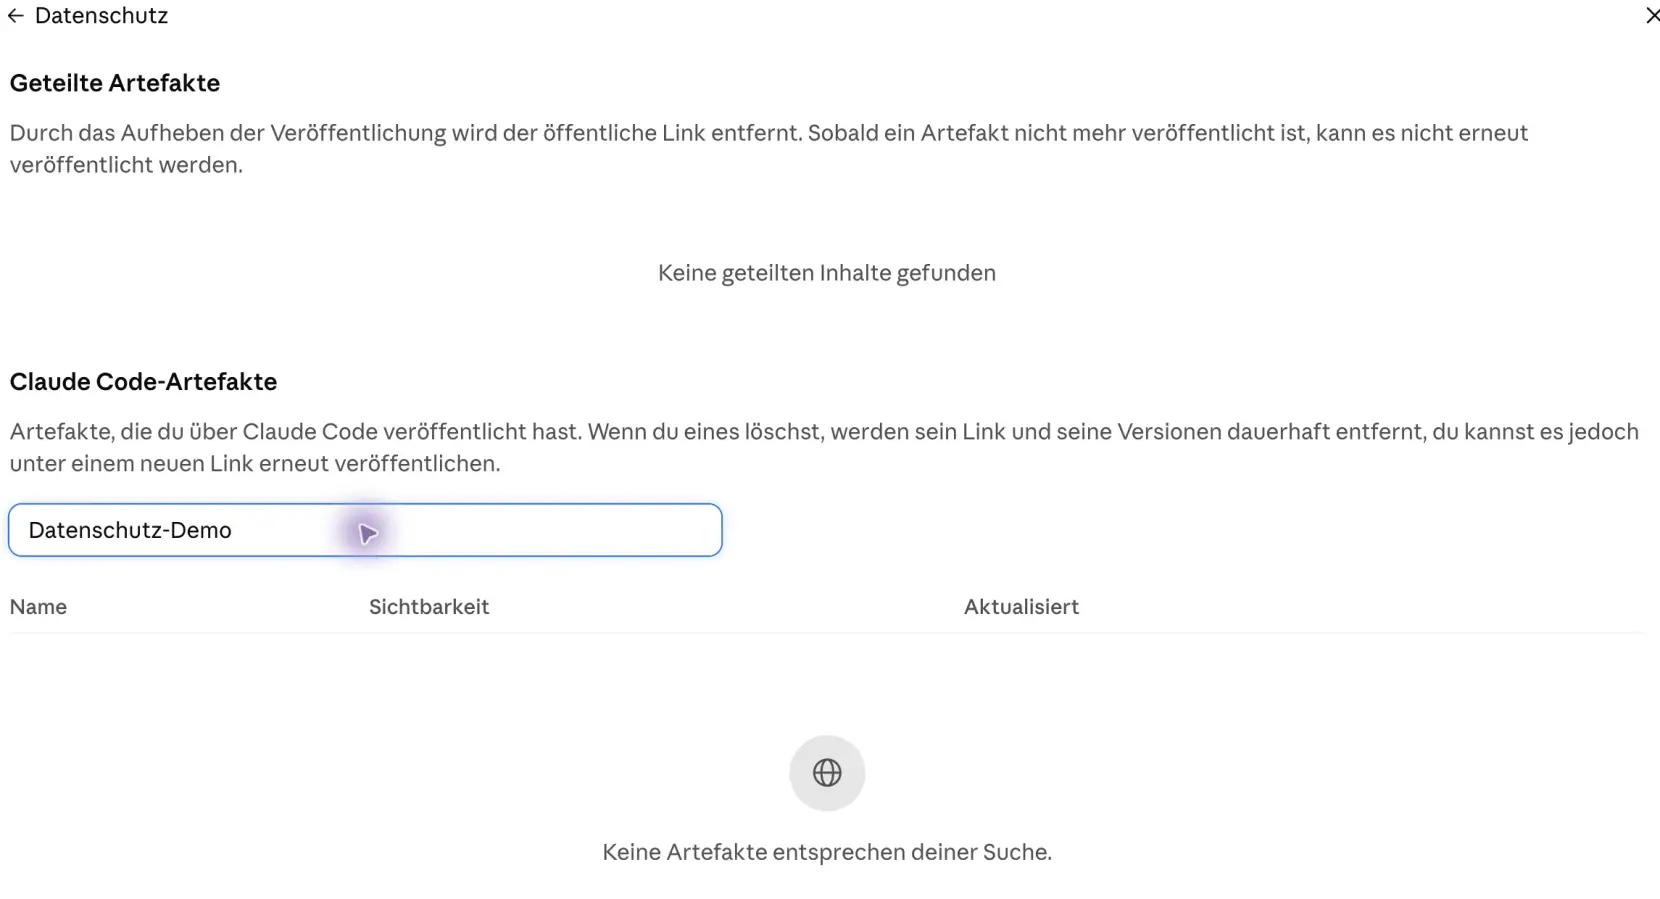
Eine einheitliche Speicherfrist für alle Artifact-Daten nennt Anthropic nicht. Für Code, den Claude in der Cloud ausführt, gibt es außerdem eigene Schalter.
7.1 Cloud-Code und Netzwerkzugriff
Diese Schalter findest du in der Desktop-Version unter Einstellungen > Funktionen. In der Aufnahme sind Codeausführung und ausgehender Netzwerkverkehr eingeschaltet. Die Domain-Zulassungsliste steht auf „Nur Paketmanager“, zusätzliche Domains sind nicht eingetragen:
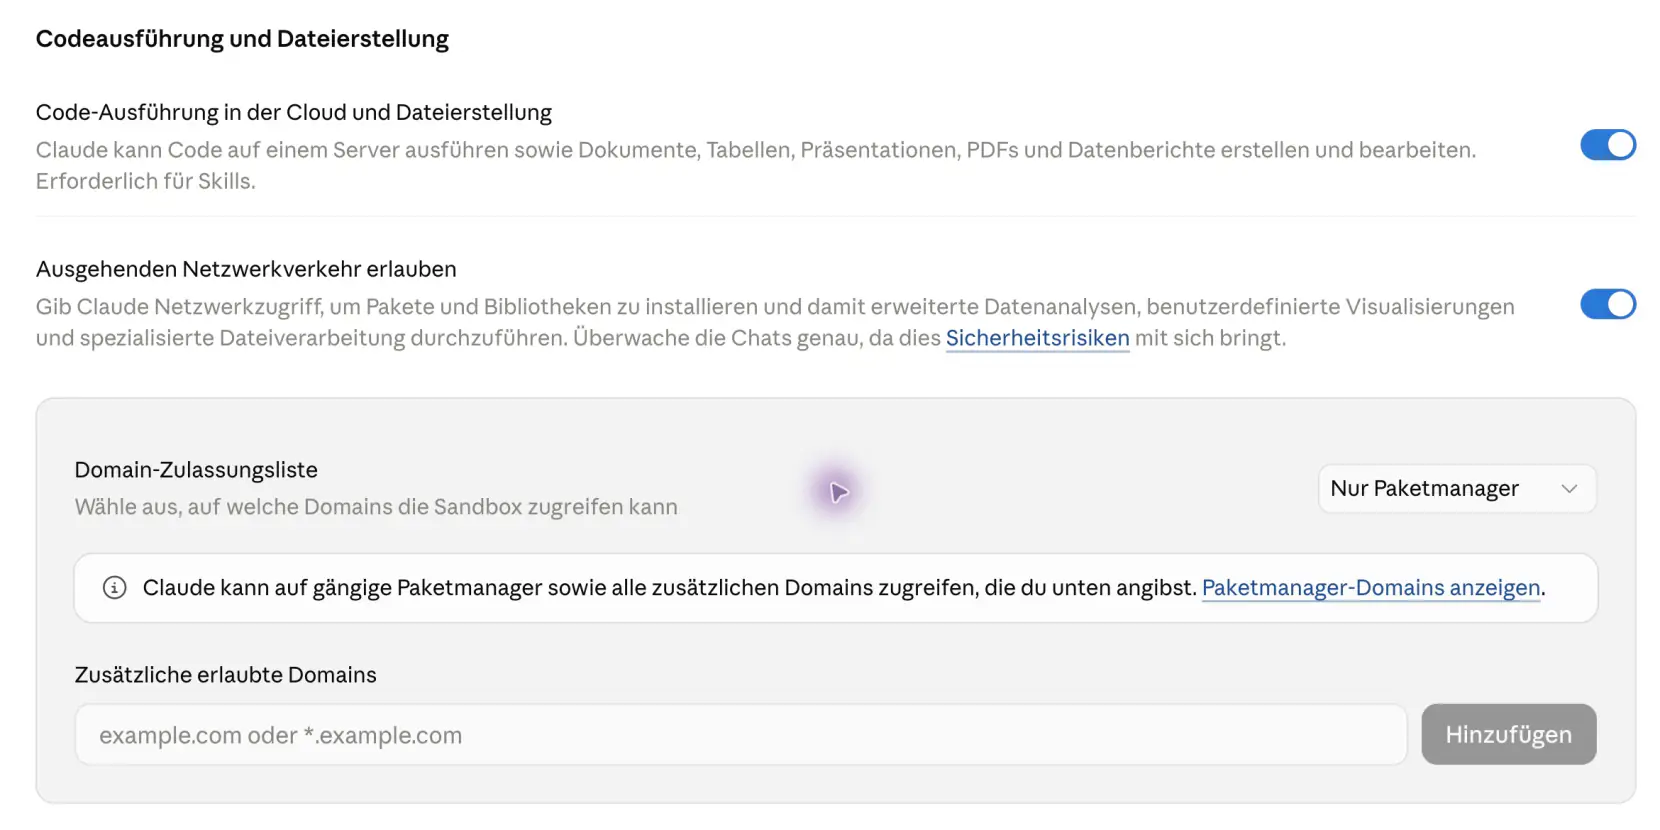
Ich würde die Liste so knapp lassen. Noch mehr Wege öffnet allerdings Cowork, weil es lokal und in der Cloud laufen kann.
8. Was sich bei Cowork lokal und in der Cloud ändert
Neue Pro-, Max- und Ultra-Aufgaben laufen seit dem 6. Oktober 2026 standardmäßig in der Cloud, so die Cowork-Hilfe. Das gilt auch, wenn du sie in der Desktop-App oder mobil startest. Die frühere Auswahl der lokalen Ausführung gibt es für neue Aufgaben dieser Tarife nicht mehr.
Bereits lokal gestartete Aufgaben können dort weiterlaufen.
Für Team ist Cloud-Cowork standardmäßig an, für Enterprise aus. Owner können das laut Organisationshilfe zu Cowork über den Schalter „Run Cowork in the cloud“ ändern. Bei Enterprise vergeben sie die Cloud-Berechtigung zusätzlich über eigene Rollen an Gruppen.
Bei lokalem Cowork läuft der Agent laut Architekturübersicht selbst auf deinem Gerät. Shell-Befehle und ausgeführter Code laufen in einer isolierten Linux-VM. Dateioperationen, WebFetch und lokale Plugin-MCP-Prozesse laufen nativ. Benötigte Prompts und Inhalte gehen trotzdem zur Modellverarbeitung an Anthropic.
Aufgaben, Uploads und Ausgaben können zusätzlich in lokalen Cowork-Ordnern liegen. Räumst du sie auf, löscht das nicht automatisch Memory, Plugins, Projektordner oder verbundene Dateien.
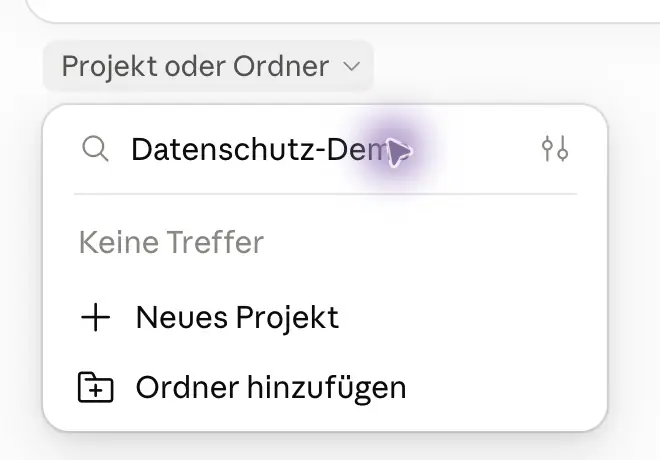
Über „Projekt oder Ordner“ erreichst du in der Desktop-App den Einstieg „Ordner hinzufügen“. Welche Dateien du freigibst und wo die Aufgabe läuft, prüfst du separat:
8.1 Cloud-Ausführung kann weitere Kopien anlegen
Im Gegensatz dazu verwirft Cowork in einer Cloud-Sitzung die Ausführungsumgebung nach dem Ende. Sitzung und zugehörige Dateien können aber in deinem Claude-Konto gespeichert bleiben. Braucht Cowork eine lokale Datei, kann es eine Kopie in die Cloud-Umgebung holen, während die Originaldatei an ihrem Ort bleibt.
Bei einer Cloud-Aufgabe kann Claude über die Desktop-App ausgewählte Ordner oder einen Browser nutzen. Verarbeitete Seiten, Screenshots und Dateiauszüge können ins Modell eingehen.
Der Netzwerkfilter der VM kontrolliert Browser-Traffic, Websuche und MCP nicht automatisch. Die Architekturübersicht unterscheidet diese Datenwege. Ich würde deshalb nur die Verbindungen freigeben, die eine Aufgabe wirklich braucht.
Enterprise-Compliance-Erfassung schafft noch einen Speicherweg. Erfasste lokale Cowork-Transkripte bleiben standardmäßig sechs Jahre oder so lange wie die eingestellte Organisationsfrist.
Bei HIPAA-Readiness sind es höchstens 30 Tage. Erfasste Cloud-Sitzungen bleiben laut Compliance-Regeln sechs Jahre, sofern der Nutzer sie nicht früher löscht.
Jede Verbindung, die Cowork oder der Chat nutzt, bringt außerdem eigene Empfänger mit.
9. Welche Integrationen zusätzliche Empfänger einbeziehen
Ein Connector bekommt Zugriff auf einen verbundenen Dienst, meist nach einer OAuth-Freigabe. Lies deshalb die angeforderten Rechte.
Unter Einstellungen > Konnektoren > GitHub prüfst du Kontoverbindung, GitHub-App und Repository-Status getrennt:
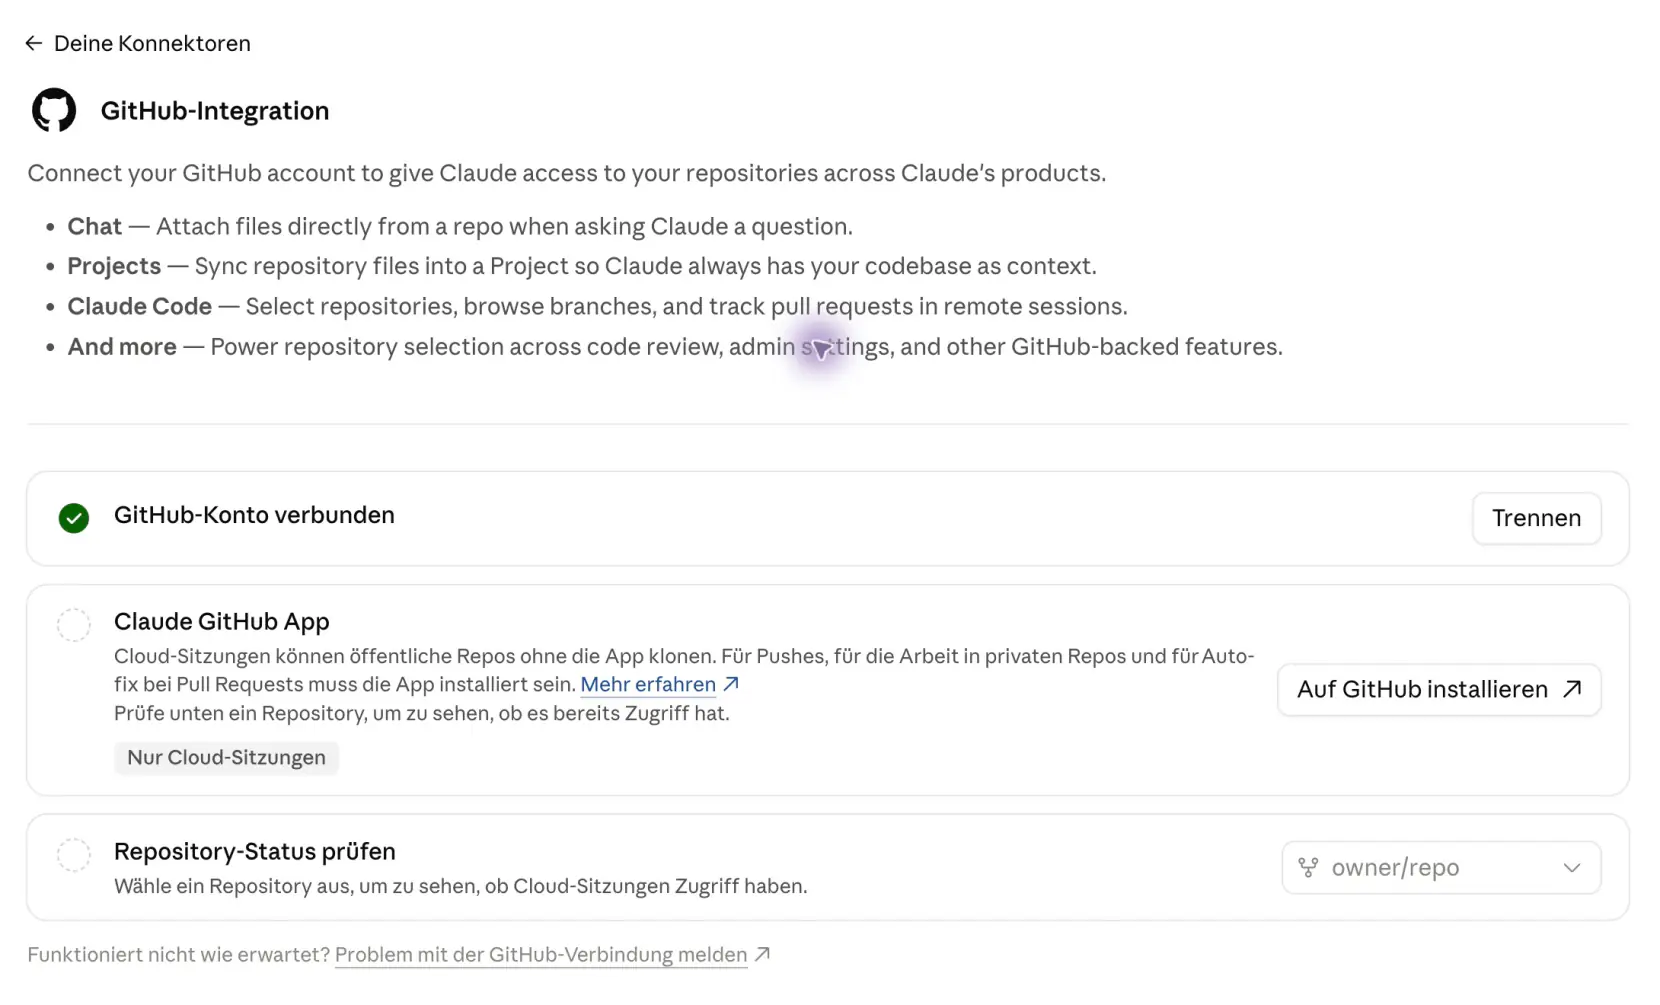
Ein schreibgeschützter Connector kann Daten abrufen. Einer mit Schreibrechten kann auch Änderungen im verbundenen Konto vornehmen. Der Anbieter oder MCP-Server kann eine weitere beteiligte Stelle mit eigenen Bedingungen sein.
Ein lokaler MCP-Server oder eine Desktop-Erweiterung läuft als normaler Prozess auf deinem Rechner. Er kann die Rechte deines Benutzerkontos nutzen. Ein entfernter MCP-Server läuft auf einem Server, und bei Cowork kann Anthropics Cloud einen Remote-Connector aufrufen. Lokale Ausführung heißt also nicht, dass jede Integration lokal bleibt.
Claude erhält nur den Kontext, den ein Werkzeugaufruf tatsächlich zurückgibt und den die Aufgabe verwendet.
Plugins können Skills, Connectoren und weitere Werkzeuge bündeln. Ein Skill ist Anweisungstext und bestimmt allein nicht den Verarbeitungsort. Entscheidend ist, ob die Anweisungen Dateien lesen, Shell-Befehle, URLs oder MCP-Werkzeuge aufrufen. Die Freigabe durch einen Workspace-Admin ersetzt keinen Blick auf den konkreten Dienst.
Mit Browser- oder Computerzugriff kann Claude sichtbare Seiten als Screenshots erhalten oder Schaltflächen bedienen. Diese Berechtigung ist keine vollständige Sicherheitsschranke zwischen Claude und deinen geöffneten Apps.
Bestehende Website-Freigaben verwaltest du in der Desktop-App unter Einstellungen > System > Erlaubte Seiten. In dieser Liste ist eine Domain hinterlegt:
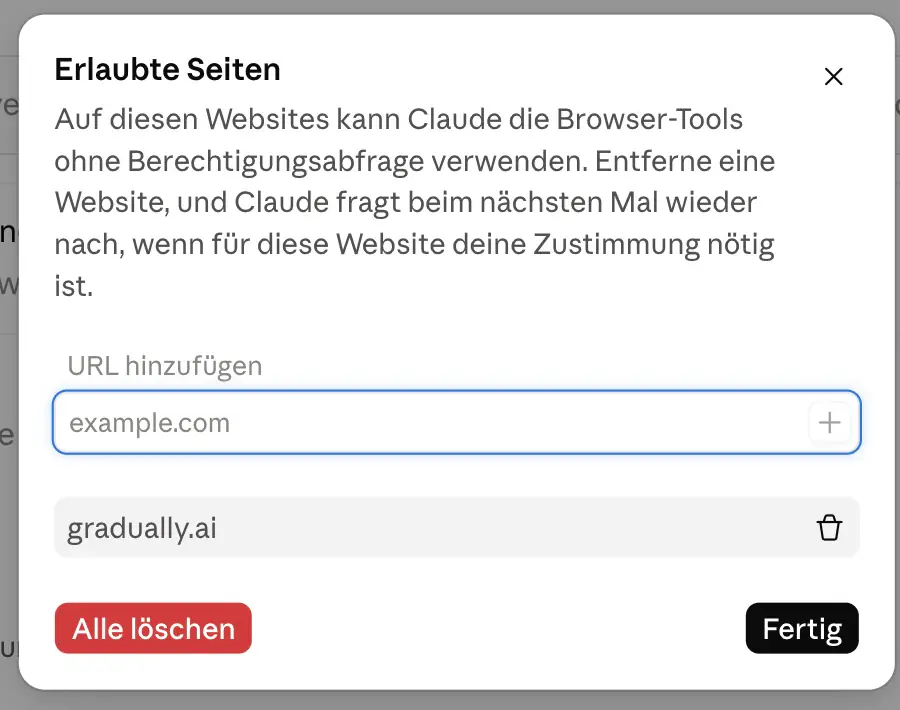
Ich würde für Kundenkonten ein getrenntes Browserprofil nutzen. Öffne keine privaten oder vertraulichen Tabs in einer Sitzung, die sie nicht sehen soll. Für Claude in Chrome sagt Anthropic keine ZDR-Unterstützung zu. Auch die Computer-Use-Funktionen unterscheiden sich nach Plan, Oberfläche und Rollout.
Noch näher an deine Dateien rückt Claude in den Office-Apps.
10. Claude in Excel, PowerPoint und weiteren Office-Apps
Dort verarbeitet ein Add-in Daten direkt aus deiner Arbeitsdatei. Claude in Excel liest und bearbeitet Arbeitsmappen, in PowerPoint nutzt und ändert es Folieninhalte. Mit appübergreifender Zusammenarbeit können Inhalte zwischen geöffneten Excel-, PowerPoint-, Word- und Outlook-Apps wandern. Schau dir deshalb vor dem Start Datei, Empfänger und Berechtigung an.
Die appübergreifende Funktion setzt eine direkte Claude-Anmeldung voraus. Für Pro und Max ist sie standardmäßig an, für Team und Enterprise aus. Adminvorgaben und Geräteeinstellungen können den Zugriff begrenzen. Ein Cloud-Anbieter-Zugang unterstützt diese Verbindung nicht automatisch.
Die Excel-Datenschutzangaben und die PowerPoint-Dokumentation nennen für Eingaben und Antworten eine Backend-Löschung innerhalb von 30 Tagen, mit Ausnahmen. Die Frist läuft ab Empfang oder Erstellung.
Kurzzeitige Caches können danach noch einige Stunden bestehen. Der Chatverlauf des Add-ins liegt separat im lokalen Browser-Speicher. Er synchronisiert sich nicht auf andere Geräte, und du bereinigst ihn gesondert.
Office-Sitzungen übernehmen weder die organisationsweite Aufbewahrung noch gewöhnliche Enterprise-Audit-Logs pauschal. Bei Enterprise-Organisationen mit aktivierter Compliance API landen die Add-in-Sitzungen dort ohne zusätzliche Einrichtung. Leerst du den Verlauf im Add-in, entfernt das nur die Kopie in deinem Browser, nicht die bei Anthropic gespeicherten Nachrichten und Dateien. Eine eigene Trainingsregel nennen die Office-Seiten nicht. Ich würde mir den Datenweg deshalb im angenommenen Vertrag bestätigen lassen.
Ein lokal installiertes Add-in heißt übrigens nicht, dass das Modell lokal rechnet. Wer Claude in eigene Software einbaut, landet ohnehin bei ganz anderen Regeln.
11. Was bei Claude API, ZDR und Datenresidenz gilt
Für eigene Software zählen die Regeln des API-Zugangs. Vertrag, Aufbewahrung und Verarbeitungsregion sind dabei drei getrennte Fragen.
11.1 Direkte API und Vertrag
Die direkte Anthropic API läuft über einen anderen Zugang als claude.ai. Für Organisationen im EWR, in der Schweiz und im Vereinigten Königreich ist Anthropic Ireland Limited Vertragspartner. Für andere Kunden ist es Anthropic, PBC. Der DPA ist in die Commercial Terms einbezogen.
Bei personenbezogenen Kundendaten bist du für deine Zwecke verantwortlich. Anthropic beschreibt sich für die Verarbeitung in deinem Auftrag als Auftragsverarbeiter.
Kommerziellen Customer Content verwendet Anthropic standardmäßig nicht fürs Training. Die kommerzielle Trainingshilfe nennt eingereichtes Feedback und Fehlerberichte als mögliche Ausnahme.
Eine Daumenbewertung kann die ganze zugehörige Unterhaltung bis zu fünf Jahre speichern. Daten aus anderen Feedback- oder Fehlerberichten bleiben nach der Aufbewahrungsregel ebenfalls fünf Jahre. Ich würde solche Einreichungen getrennt von normalen API-Anfragen behandeln.
11.2 Speicherfunktionen und Zero Data Retention
Normale direkte API-Ein- und Ausgaben löscht Anthropic laut API-Aufbewahrungsregeln automatisch innerhalb von 30 Tagen, doch das ist keine Obergrenze für jedes API-Objekt. Dateien der Files API bleiben, bis du sie löschst oder ihr Ablauf greift. Beim Upload setzt du eine Laufzeit zwischen einer Stunde und 90 Tagen.
Der Ablauf sperrt den API-Zugriff, löscht aber nicht garantiert sofort. Inhalte können vorübergehend für Sicherheitszwecke bestehen bleiben, und Metadaten können nach dem Ablauf noch bis zu 30 Tage sichtbar sein. Verlass dich deshalb auf den Löschweg, nicht allein auf das Ablaufdatum.
Die Files API ist nicht ZDR-fähig.
Nachrichten-Batches können bis zu 29 Tage ab ihrer Erstellung bestehen und sind ebenfalls nicht ZDR-fähig. Auch die Skills API ist ausgeschlossen, eine feste Frist gibt es dafür nicht.
Prompt Caching ist bei der direkten API ZDR-fähig, wenn die übrige Anfrage berechtigt ist. Cache-Daten liegen nur im Arbeitsspeicher, standardmäßig fünf Minuten oder erweitert eine Stunde. Andere Datenwege im selben Workspace werden dadurch nicht speicherfrei.
Zero Data Retention (ZDR) heißt, dass Anthropic geeignete API-Ein- und Ausgaben nach der Antwort nicht im Ruhezustand speichert. Anthropic muss ZDR für die Organisation ausdrücklich freischalten. Es gilt nur für berechtigte Modelle, Endpunkte und Funktionen. Console, Playground und Features mit eigenem Speicher sind ausgeschlossen.
Auch einzelne Modelle unterliegen einer verpflichtenden Aufbewahrung. Claude Fable 5.2, Claude Mythos 5.2, Claude Fable 5.1, Claude Mythos 5.1, Claude Fable 5 und Claude Mythos 5 gelten als Covered Models und verlangen 30 Tage Aufbewahrung. In Workspaces, Claude-Enterprise-Organisationen und bei Drittplattformen ist ZDR für sie nicht verfügbar. Berechtigten Kunden bietet Anthropic befristet eine ZDR-Option für Fable 5 und Fable 5.1 bei internen Geschäftsanwendungen an, als Übergang zu Anthropics neuen Schutzmaßnahmen für Unternehmen (EFS). Für die Mythos-Modelle nennt Anthropic diese Option nicht. Bevor du ZDR für eine Produktionsanfrage voraussetzt, schau in die aktuelle Modell- und Funktionsliste. Telemetrie, Missbrauchsprüfung, Sicherheitsklassifikationen, Support, Compliance-Exporte, lokale Kopien und Cloud-Anbieter deckt ZDR nicht automatisch ab.
Selbst unter ZDR erlaubt die API-Richtlinie längere Speicherung bei gesetzlichen Pflichten. Als Sicherheitsfall markierte Eingaben und Antworten können bis zu zwei Jahre bestehen bleiben. Nach der aktuellen Matrix sind auch Managed Agents, serverseitige Code-Ausführung und weitere Funktionen nicht ZDR-fähig.
11.3 Region und Cloud-Anbieter
Laut Datenresidenz-Doku bietet die direkte API aktuell global und us als Inferenzregionen. Eine EU-Region gibt es nicht, und die Workspace-Speicherregion ist US. Der Parameter inference_geo steuert, wo ein passender Request verarbeitet wird.
Der Parameter workspace_geo betrifft Daten im Ruhezustand. Regionale Inferenz heißt also nicht, dass Supportdaten, Logs oder jedes Metadatum ebenfalls dort liegen.
Bei Bedrock greifen AWS-Verträge und die in AWSs Anthropic-Bedingungen einbezogenen Commercial Terms samt DPA. Invocation Logging ist standardmäßig aus. Schaltest du es ein, entstehen Kopien in S3 oder CloudWatch.
Entfernst du die Logging-Konfiguration später, stoppt nur die künftige Protokollierung, denn vorhandene Logs löschen erst passende Aufbewahrungs-, Lifecycle- oder Löschregeln.
Cross-Region-Inference richtet sich nach dem konkreten Modellprofil und dessen Geografie.
Für die Gemini Enterprise Agent Platform verweist Google auf dieselbe Regel „Separate Offerings“ und auf die jeweilige Modellkarte. Lies diese Unterlagen für dein Projekt.
Optionale Request-Response-Logs, allgemeine Missbrauchsüberwachung und erweitertes AI-Monitoring sind unterschiedliche Kontrollen mit eigenen Fristen. Die Region eu ist eine EU-Multiregion, keine einzelne Länderregion. Verfügbarkeit, Modell und Verarbeitung hängen vom jeweiligen Projekt ab.
Ein Vertrag für Claude auf Google Cloud oder eine EU-Region bringt Anthropics API-Aufbewahrung und ZDR-Regeln nicht automatisch mit.
Compliance- und Supportdaten haben eigene Regeln. Für erfasste lokale Claude-Code-Sitzungen nennt die Compliance-Dokumentation sechs Jahre oder die eingestellte Organisationsfrist. Bei HIPAA-Readiness sind es höchstens 30 Tage. Aktives ZDR schließt die entsprechenden lokalen Sitzungen aus.
Damit ist die technische Seite geklärt. Offen bleibt, was die DSGVO von dir selbst verlangt.
12. Was die DSGVO zusätzlich von dir verlangt
Ein AVV und ausgeschaltetes Training sind Bausteine, mehr nicht. Ob du personenbezogene Daten für deinen Zweck verwenden darfst, beantworten sie nicht.
Dafür brauchst du eine Rechtsgrundlage nach Art. 6 DSGVO, bei Gesundheitsdaten zusätzlich eine Ausnahme nach Art. 9 DSGVO. Dazu kommen Informationspflichten, Verarbeitungsverzeichnis, Schutzmaßnahmen, Drittlandtransfer und bei hohem Risiko eine Datenschutz-Folgenabschätzung. Die Liste gilt für Claude und ChatGPT gleich, ausführlich steht sie im DSGVO-Abschnitt meines ChatGPT-Ratgebers.
Beeinflussen KI-Ergebnisse Entscheidungen über Menschen, kommt Art. 22 dazu. Die Stellungnahme 28/2024 des Europäischen Datenschutzausschusses und die Orientierungshilfe der deutschen Datenschutzkonferenz ordnen KI dabei ein. Ich würde diese Fragen vor dem ersten echten Kundenprojekt klären, nicht danach.
Bei Claude Code kommt noch eine Ebene dazu, denn dort liest der Agent deine Dateien selbst.
13. Claude Code: Dateien, Werkzeuge und Berechtigungen
Claude Code kann Dateien in deinem Projekt lesen und Befehle ausführen.
Ich arbeite seit Mitte 2025 mit Claude Code. In über 800 Stunden habe ich damit Hunderte Apps, Skripte und Websites gebaut. Auch eigener Code kann personenbezogene Daten oder Geheimnisse enthalten; das Eigentum am Code entscheidet nicht über den Datenschutz.
Bei Kundenprojekten können Namen in Testdaten, Zugangsdaten in der .env-Datei und echte Bestellungen im Fehlerlog stehen. Nimmt der Agent sie in den Modellkontext auf, gehen sie an den ausgewählten Anbieter.
Darf das sein? Und wenn ja, mit welchem Tarif?
Die Claude-Code-Anleitung erklärt die Werkzeuge. Die folgenden Abschnitte ordnen ihre eigenen Datenschutzwege ein.
13.1 Claude Code Datenschutz auf einen Blick
Bei Claude Code entscheidet nicht die Software über den Datenschutz, sondern der Weg, über den du dich anmeldest. Dieselbe CLI schickt deine Daten je nach Konto in ganz unterschiedliche Vertragswelten:
Bedrock und Google Cloud haben eigene Bedingungen für ihre Verarbeitung. Für Anthropics Bedrock-Angebot gelten zugleich die in AWSs Bedingungen einbezogenen Anthropic Commercial Terms samt DPA. Für Claude auf Google Cloud gilt die oben beschriebene Regel „Separate Offerings“ aus der Google-Dokumentation. Welche Verarbeitung welcher Vertrag abdeckt, hängt vom Zugang und Kundenvertrag ab.
Übertrage weder direkte API-Fristen noch ZDR automatisch auf die Cloud-Anbieter.
Für Kundenprojekte rate ich dir zu Team, Enterprise oder einem API-Schlüssel deiner Firma. Wie du dahin kommst und was du danach noch einstellen musst, zeigen dir die sieben Schritte.
13.2 Wähle einen Tarif mit AVV
Zuerst kommt der Tarif, und ein teures Abo macht noch keinen Firmentarif. Claude Max kostet 100 $ und Ultra 200 $ im Monat. Beide gehören trotzdem zu den Privattarifen, genau wie Free und Pro:
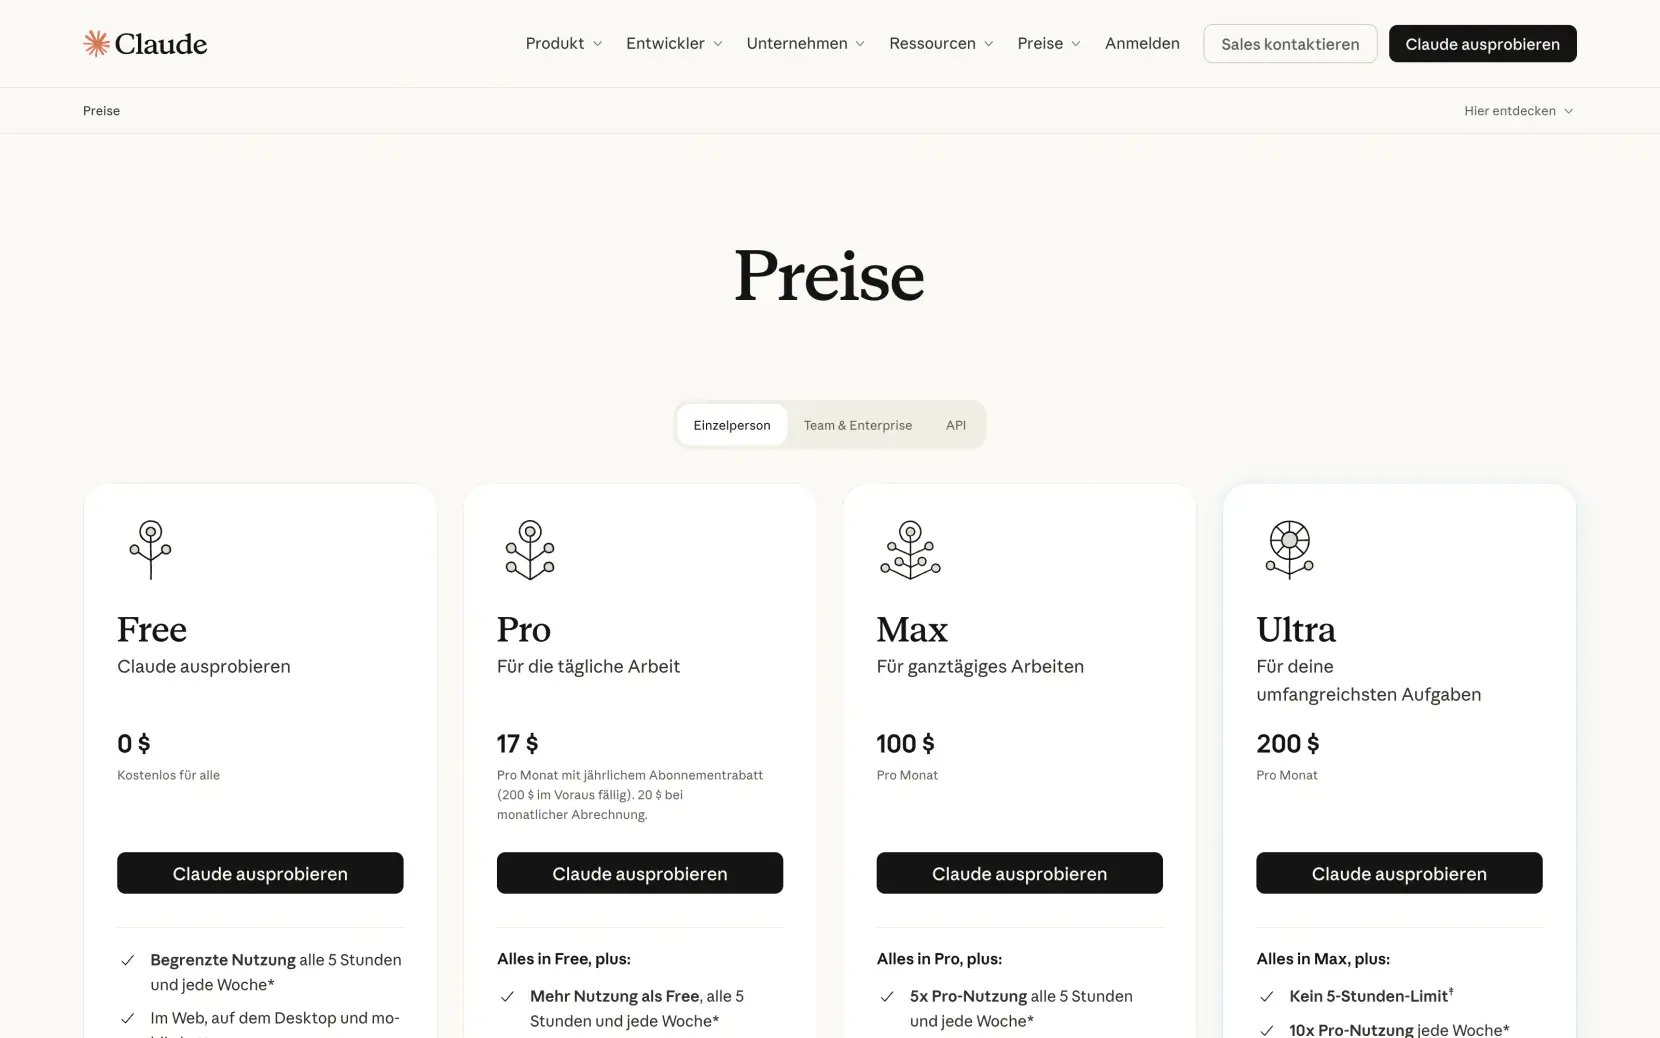
Den Auftragsverarbeitungsvertrag von Anthropic (auf Englisch Data Processing Addendum) gibt es nur zu den Commercial Terms. Die gelten für Team, Enterprise und die API, nicht für Free, Pro, Max und Ultra. Der AVV enthält auch die EU-Standardvertragsklauseln für die Übermittlung in die USA.
Unter den Commercial Terms verwendet Anthropic Inhalte standardmäßig nicht fürs Training. Freiwillige Freigaben, etwa im Development Partner Program, sowie Sicherheitsprüfungen sind gesondert zu beachten. Gewöhnliche direkte API- und Claude-Code-Ein- und Ausgaben unterliegen der 30-Tage-Regel.
Soll Anthropic personenbezogene Daten in deinem Auftrag verarbeiten, brauchst du einen Team- oder Enterprise-Arbeitsbereich oder einen Organisations-API-Schlüssel. Nicht jeder Quellcode hat Personenbezug; Kundenvereinbarungen und Vertraulichkeit bleiben trotzdem relevant. Preise erklärt mein Artikel zu den Claude-Code-Kosten.
Allerdings kann eine Enterprise-Organisation eine weitere Kopie anlegen. Die Compliance API speichert erfasste Claude-Code-Sitzungen samt gelesener Dateien standardmäßig sechs Jahre oder eine konfigurierte Organisationsfrist. Bei aktivierter HIPAA-Readiness sind es 30 Tage oder eine kürzere Organisationsfrist. Ob das bei euch aktiv ist, weiß dein Admin.
Claude Code ZDR muss Anthropic für jede berechtigte Enterprise-Organisation gesondert aktivieren. Es deckt geeignete Modellaufrufe dieser Organisation ab, nicht Claude-Chats, Cowork oder externe Dienste. Cloud-Sitzungen, Remote Control, Feedback, Artifacts, Claude Tag und die vereinte Chat- und Cowork-Oberfläche sind dabei gesperrt. Claude Fable 5.2, Fable 5.1 und Fable 5 kann eine ZDR-Organisation nur nutzen, wenn die Regeln für Covered Models das erlauben. Gesetzliche Pflichten und Sicherheitsfälle bleiben Ausnahmen.
Ein persönlicher Login oder Schlüssel einer anderen Organisation übernimmt die Zusage nicht.
13.3 Schalte bei Pro, Max und Ultra die Modellverbesserung ab
Nutzt du für eigene Projekte weiter Pro, Max oder Ultra, zählt dein persönlicher Schalter. Der Schalter zur Modellverbesserung regelt die normale Trainingsnutzung und Aufbewahrungsfrist, während Feedback, Sicherheitsfälle und andere Datenwege getrennt davon laufen.
Öffne auf claude.ai dein Profilmenü und dann Einstellungen > Datenschutz. Der Schalter heißt in der abgebildeten Oberfläche „Help improve our AI models“. Schalte ihn aus. Nach Anthropics Hilfe zur Modellverbesserung gilt er auch für Claude Code, wenn du dich mit diesem Konto anmeldest.
Die Trainingseinstellung im Claude-Konto zeigt denselben Schalter, der auch für deine angemeldeten Code-Sitzungen gilt.
Anthropic nennt bis zu fünf Jahre für von der Nutzerkennung getrennte Daten, die bei aktivierter Modellverbesserung in die Trainingspipeline eingehen. Die 30 Tage beziehen sich unter anderem auf die Backend-Löschung, nachdem du einen Chat löschst.
Anthropic beschreibt den Ausgangszustand nicht für alle Konten einheitlich. Schau deshalb in dein eigenes Konto.
Auch mit abgeschaltetem Schalter gibt es eine Ausnahme. Markiert Anthropic eine Unterhaltung als Sicherheitsfall, darf es sie für seine Sicherheitsmodelle verwenden.
Neben dem Training schickt Claude Code noch Diagnosedaten an Anthropic. Die stellst du direkt im Terminal ab.
13.4 Schalte Telemetrie, Fehlerberichte und Feedback ab
Zu diesen Diagnosedaten gehören auch Fehlerberichte. Über den direkten Anthropic-Weg sind sie bei Pro, Max und Ultra seit 2.1.198 standardmäßig an. Ausnahmen gelten etwa für ZDR und HIPAA-Readiness.
Laut Datennutzungs-Doku sind bei Bedrock und Google Metriken, Fehlerberichte und /feedback anders voreingestellt. Umfragen und WebFetch-Prüfungen sind eigene Datenwege.
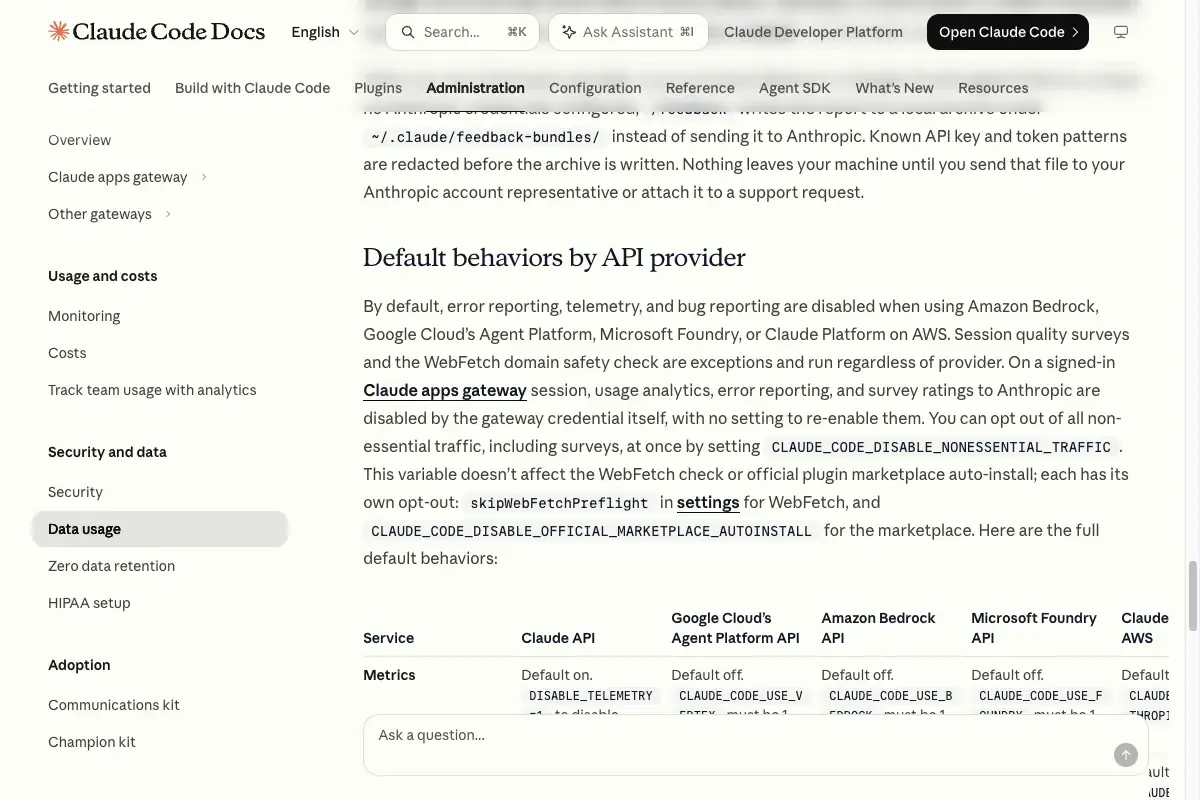
Diese vier Umgebungsvariablen setzt du vor dem Start von Claude Code:
export DISABLE_TELEMETRY=1
export DISABLE_ERROR_REPORTING=1
export DISABLE_FEEDBACK_COMMAND=1
export CLAUDE_CODE_DISABLE_FEEDBACK_SURVEY=1
claude
So gelten sie nur für dieses Terminalfenster. Dauerhaft wirken sie im Block env deiner settings.json oder, für ein ganzes Team, über Managed Settings.
Das Absenden von /feedback, /bug oder /share ist eine eigene Übermittlung und kann das zugehörige Transkript enthalten. Das kann bis zu fünf Jahre gespeichert bleiben. Ein Umfrage-Rating ist davon getrennt. Erst wenn du Gesprächsdaten ausdrücklich freigibst, wird ein Transkript hochgeladen; dafür nennt Anthropic bis zu sechs Monate.
API-Schlüssel werden teilweise erkannt, Datei- und Quellcodeinhalte aber nicht allgemein entfernt. Bei Bedrock, Vertex, Microsoft Foundry, Claude Apps Gateway und Sitzungen ohne Anthropic-Zugangsdaten bleibt ein freigegebenes Feedback-Paket lokal. Es geht erst raus, wenn du es selbst weiterleitest oder anhängst.
Telemetrie enthält nach Anthropics Angaben weder Prompts noch Code. Abschalten würde ich sie trotzdem.
Es gibt noch einen Sammelschalter namens CLAUDE_CODE_DISABLE_NONESSENTIAL_TRAFFIC=1. Er schaltet alles Nicht-Notwendige auf einmal ab, auch Remote Control und die automatischen Updates. Wenn du ihn setzt, brauchst du einen anderen Weg für Sicherheitsupdates.
skipWebFetchPreflight in den Settings. Die automatische Plugin-Installation stoppt erst mit CLAUDE_CODE_DISABLE_OFFICIAL_MARKETPLACE_AUTOINSTALL=1.Diese Schalter schließen bestimmte zusätzliche Datenwege. Modellanfragen bleiben nötig, und Werkzeuge, Hooks und Integrationen können weitere Verbindungen öffnen. Bleibt die wichtigste Frage, nämlich was Claude Code lesen und weitergeben darf.
13.5 Sperre Geheimnisse für Read-Tool und Sandbox
Ein Prompt wie „Lies die .env nicht“ ist eine Bitte. Eine technische Grenze ziehst du erst in der Datei .claude/settings.json im Projektordner:
{
  "permissions": {
    "blockReadsOutsideWorkingDirectories": true,
    "deny": [
      "Read(./**/.env)",
      "Read(./**/.env.*)"
    ]
  },
  "sandbox": {
    "enabled": true,
    "failIfUnavailable": true,
    "allowUnsandboxedCommands": false,
    "filesystem": {
      "denyRead": ["~/", "./**/.env", "./**/.env.*"],
      "allowRead": ["."]
    }
  }
}
Du brauchst beide Blöcke für das Read-Tool und sandboxierte Shell-Befehle. denyRead allein sperrt das Read-Tool nicht. Laut Sandbox-Doku bedeutet . in Projekteinstellungen den Projektordner, in ~/.claude/settings.json dagegen ~/.claude.
Übertrage das Beispiel deshalb nicht unverändert in globale Einstellungen.
Achte auch auf vorhandene excludedCommands, die Befehle außerhalb der Sandbox ausführen.
Mit failIfUnavailable startet Claude Code gar nicht erst, wenn die Sandbox fehlt. Das passiert auf nativem Windows, denn die Sandbox läuft nur unter macOS, Linux und WSL2.
Projektdateien lassen sich lokal verändern.
Für verbindliche Vorgaben brauchst du Managed Settings mit den passenden administrativen Sperren, nicht nur eine verteilte Kopie. Soll die Grenze auch andere Prozesse erfassen, nimm eine separate VM oder einen Container mit begrenzten Mounts, Netzwerk und Zugangsdaten.
Die Sandbox begrenzt Dateien und Netzwerk für erfasste Befehle. Sie bestimmt weder die Modellregion noch die Datenwege außerhalb ihres Geltungsbereichs.
In Claude Desktop findest du unter Einstellungen > Claude Code die Schalter „Lokale Sandbox“ und „Strikter Sandbox-Modus“. Für eine Konfiguration wie oben aktivierst du beide und startest eine neue Sitzung. Die Dateisperren aus der Projektkonfiguration brauchst du weiterhin.
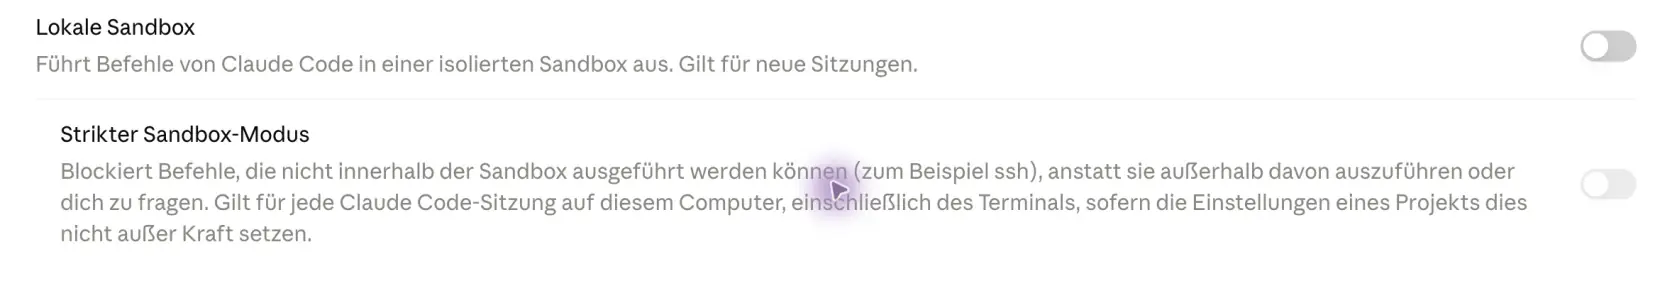
Die Sandbox klärt, was Claude Code liest. Wo das Modell rechnet, entscheidet dagegen dein Anbieter.
13.6 Entscheide, ob du EU-Verarbeitung brauchst
Die direkte Anthropic-API rechnet in den USA oder weltweit. Eine EU-Option gibt es in der Doku zur Datenresidenz nicht:
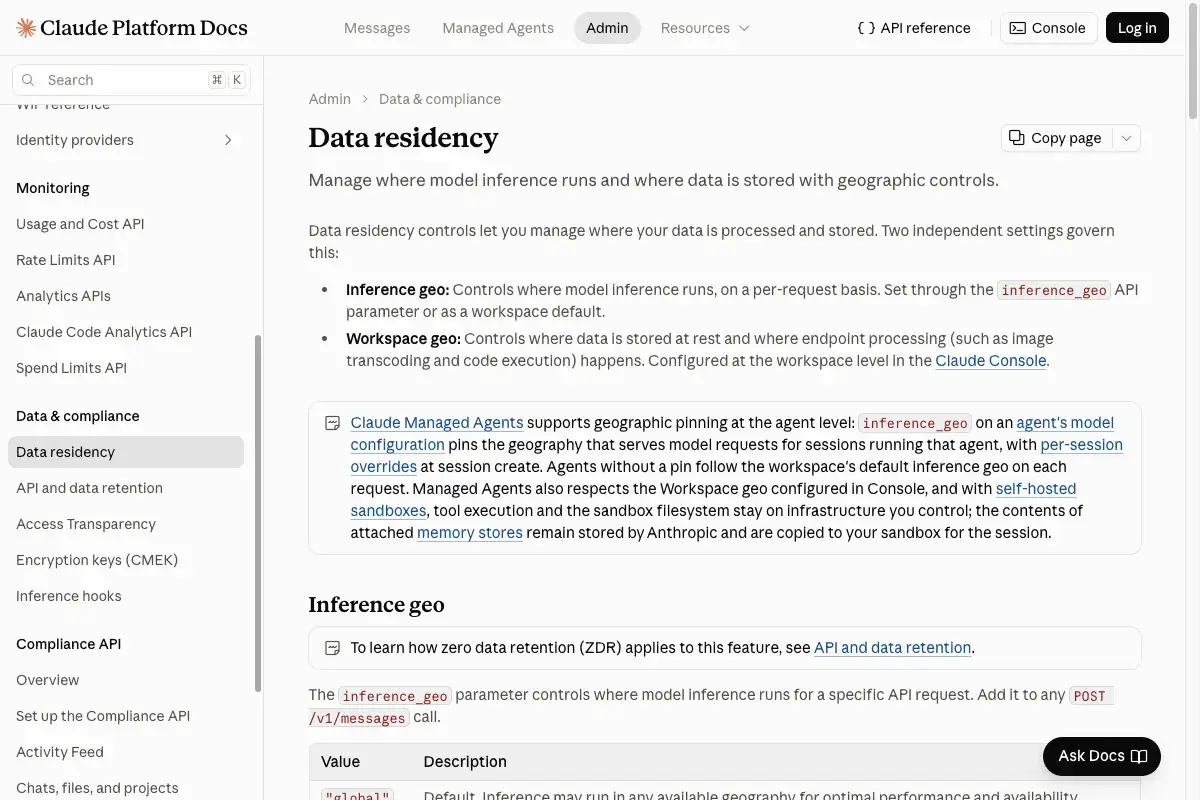
Bei unterstützten Claude-4.6+-Modellen bietet inference_geo global oder us. us kostet das 1,1-Fache; ältere Modelle unterstützen diese Einstellung nicht. Workspace-Daten werden in den USA gespeichert.
Verlangt dein Kunde Verarbeitung in der EU, führt der Weg über einen Cloud-Anbieter. Claude Code läuft mit CLAUDE_CODE_USE_BEDROCK=1 über Amazon Bedrock und mit CLAUDE_CODE_USE_VERTEX=1 über Google Vertex AI. Bedrock bietet EU-Inference-Profiles, Vertex die Region eu.
Welche Modelle es dort in der EU gibt, ändert sich laufend. Das musst du für dein Modell und dein Konto selbst nachsehen. Die Provider-Schalter wählen allein keine EU-Region. Konfiguriere auch Konto, Endpoint und ein regional geeignetes Modell oder Inferenzprofil.
Schließe unzulässige Regionen und Fallbacks aus und kontrolliere die tatsächliche Route.
EUrouter bewirbt eine Claude-Code-Integration mit EU-Routing. Für die konkrete Modellroute genügt diese Anbieterangabe allein nicht.
AVV, nachgelagerte Empfänger, tatsächliche Inferenzregion und Fallbacks musst du dort selbst klären. Weil der Gateway ein zusätzlicher Dienstleister ist, würde ich für Kundenprojekte zuerst die direkten Wege über AWS oder Google nehmen.
Ein EU-Modell hält allerdings nicht alles in der EU. Drei Funktionen öffnen eigene Wege.
13.7 Gib Remote Control, Cloud-Sitzungen und MCP-Server einzeln frei
Die erste dieser drei Funktionen ist Remote Control. Dabei bleiben Werkzeuge lokal, während Prompts, Antworten und Werkzeugaktivität zusätzlich bei Anthropic landen. Dafür brauchst du einen unterstützten Claude.ai-Abonnement-Login. API-Keys, setup-token, CLAUDE_CODE_OAUTH_TOKEN, Bedrock, Google Cloud Agent Platform, Microsoft Foundry, Claude Apps Gateway und eigene Nicht-Anthropic-Gateways werden nicht unterstützt.
Seit Claude Code 2.1.283 sperrt DISABLE_TELEMETRY allein Remote Control nicht, außer die Organisation verlangt Trusted Devices. CLAUDE_CODE_DISABLE_NONESSENTIAL_TRAFFIC, ZDR und disableRemoteControl sperren es. Das Transkript bleibt eine eigene Anthropic-Speicherung; ZDR und HIPAA-Konfiguration sind dafür nicht verfügbar.
Anthropic-gehostete Cloud-Sitzungen laufen standardmäßig in isolierten VMs, Team- und Enterprise-Organisationen können aber die öffentliche Beta für selbst gehostete Sitzungen aktivieren. Dann liegen Runner, Checkout und Build-Dateien in der eigenen Infrastruktur, Control-Plane, Sitzungstranskript und Modellverarbeitung bleiben aber weiterhin mit Anthropic verbunden. Lokale Uploads können die ganze Git-Historie einschließlich committeter Geheimnisse enthalten.
Unter macOS, Linux und WSL filtert der Upload bestimmte nicht committete Änderungen an typischen Credential-Dateien. Natives Windows hat diesen Dateinamenfilter nicht. Schau dir jeden Upload deshalb selbst an.
MCP-Server verbinden Claude Code mit weiteren Diensten wie Datenbanken, Kalendern oder Ticketsystemen. Ein entfernter MCP-Server bekommt alles, was der Agent ihm schickt, und für ihn gilt der AVV von Anthropic nicht.
Ich würde für ein Kundenprojekt zunächst alle drei abschalten. Danach gibst du nur das frei, was das Projekt wirklich braucht, und notierst für jede Freigabe, wer die Daten bekommt.
13.8 Teste die Grenzen mit erfundenen Daten
Jede Freigabe und jede Sperre bleibt allerdings eine Vermutung, solange du sie nicht getestet hast. Lege deshalb einen Testordner mit erfundenen Kundendaten und einer gesperrten .env-Datei an und gehe diese fünf Punkte durch:
- Starte Claude Code genau so, wie du es im Projekt starten wirst, mit demselben Konto.
- Bitte Claude Code, die gesperrte
.env-Datei zu lesen. Das Read-Tool muss ablehnen. - Bitte es, die Datei mit
catauszugeben. Die Sandbox muss ablehnen. - Wiederhole den Versuch für jeden Hook und jeden MCP-Server, den du freigegeben hast.
- Kontrolliere am Ende, dass
/feedbackdeaktiviert ist und keine Remote-Control-Sitzung läuft.
Greift eine Sperre nicht, bleibt das Projekt gesperrt, bis du die Einstellung korrigiert und erneut getestet hast. Ein zusätzlicher Satz im Prompt repariert keine Sandbox.
Die CLI speichert Klartextprotokolle unter ~/.claude/projects. Die lokale Bereinigung steht standardmäßig auf 30 Tagen (cleanupPeriodDays). Ausgenommen sind Transkripte von Sitzungen, die in Desktop oder Cowork gestartet oder zuletzt dort fortgesetzt wurden.
Für diese kann eine eigene Desktop-Aufbewahrung gelten. Managed Settings und bestimmte HIPAA-Konfigurationen ändern die Standardeinstellung.
Das ist keine Löschfrist für Cowork-Dateien oder Sitzungen im Claude-Konto, und lokale Kopien und Backups räumst du getrennt auf.
Die Ergebnisse gehören in deine KI-Richtlinie fürs Unternehmen. So arbeitet jeder im Team mit denselben Grenzen.
13.9 Was die DSGVO dabei von dir verlangt
Die Grenzen aus den sieben Schritten senken bestimmte Risiken. Rechtsgrundlage, Rollen, Drittlandtransfer, besondere Datenkategorien und Folgenabschätzung bleiben trotzdem deine Aufgabe. Die vollständige Liste steht im DSGVO-Abschnitt meines ChatGPT-Ratgebers, denn sie gilt für alle Coding-Agenten gleich.
Bei Claude Code würde ich auf zwei Punkte besonders achten. Arbeitest du selbst im Auftrag, brauchst du vor weiteren Unterauftragsverarbeitern die Genehmigung des Verantwortlichen nach Art. 28 Abs. 2 DSGVO. Außerdem führt Anthropics Standard-AVV keine besonderen Kategorien auf. Gesundheitsdaten oder biometrische Daten gibst du dem Agenten deshalb nicht ohne gesonderte rechtliche und vertragliche Klärung.
Wie du einen Transfer bewertest, zeigen die Empfehlungen des EDSA zu Drittlandtransfers. Für alles andere empfehle ich die Orientierungshilfe der Datenschutzkonferenz zu KI und die EDSA-Leitlinien zu Verantwortlichen und Auftragsverarbeitern. Wie Codex und Cursor dieselben Fragen beantworten, zeigt dir der Vergleich.
13.10 Claude Code, Codex und Cursor im Datenschutz-Vergleich
Wägst du gerade zwischen Claude Code, Codex und Cursor ab, hilft dir dieser Überblick. Sie unterscheiden sich vor allem darin, ab welchem Tarif es einen AVV gibt und wie du das Training abschaltest:


OpenAI nennt für Edu eine eigene Student Data Privacy Agreement. Dort zählt diese Vereinbarung samt Order Form und institutionellen Ergänzungen. Die Speicherwerte in der Tabelle beziehen sich auf Code- oder API-Daten, mit Ausnahmen, für gespeicherte Chats gelten eigene Löschregeln.
Wie du Codex einstellst, erklärt meine Anleitung zu Codex und Datenschutz. Für Cursor findest du alles in der Anleitung zu Cursor und Datenschutz.
14. Dein nächster Schritt
Für Claude gilt dabei dasselbe wie für Codex und Cursor. Ein Tarif mit AVV, wenige Datenwege und getestete Sperren sind die Bausteine, auf denen ein zulässiger Einsatz aufbaut. Der kleinste davon kostet dich nur eine Minute.
Öffne auf claude.ai Einstellungen > Datenschutz und schalte „Help improve our AI models“ aus, falls er noch an ist. Das kostet nichts, lässt sich jederzeit ändern und gilt auch für Claude Code, wenn du dich mit diesem Konto anmeldest.
Häufig gestellte Fragen
Ja. Claude Code sendet Prompts und Modellantworten an den gewählten Anbieter. Laut Anthropics aktueller Datenrichtlinie gilt für Free, Pro, Max und Ultra: Wenn du Modellverbesserung erlaubst, kann Anthropic Inhalte, die in die Trainingspipeline gelangen, bis zu fünf Jahre behalten; wenn nicht, gilt für Claude-Code-Daten standardmäßig eine Frist von 30 Tagen.
Für die kommerzielle API gilt in der Regel ebenfalls eine Löschung innerhalb von 30 Tagen, vorbehaltlich längerer Speicherung durch andere Dienste, Vereinbarungen oder Sicherheitsfälle. Claude for Work speichert Chats im Produkt, bis du sie löschst; Enterprise-Organisationen können eigene Aufbewahrungsfristen festlegen.
Lokale Transkripte unter ~/.claude/projects liegen als Klartext auf deinem Gerät und werden standardmäßig nach 30 Tagen entfernt. Transkripte von Sitzungen, die du in Claude Desktop oder Cowork gestartet oder zuletzt fortgesetzt hast, sind standardmäßig von dieser Frist ausgenommen.